flexMIRT™ 技术支持
SSI, Inc. 通过电子邮件提供技术支持服务。该服务仅面向 SSI 软件产品的注册最终用户。获取技术支持的政策与流程请点击此处查看。
该服务适用于软件使用中遇到的问题,不包含统计咨询服务。
文档
常见问题(FAQ)
安装与设置
我需要在未连接互联网的计算机上注册 flexMIRT™,该怎么做?
如需在无互联网访问的计算机上注册 flexMIRT™,请通过我们的支持门户提交请求。
数据
我一直收到"Error: Out of range for file…"错误,这是什么意思?
您很可能使用了非零起点的数据。flexMIRT™ 要求响应从 0 开始向上编号。如果您使用的是响应值为 1,2,3,4 的等级数据,需要在 <Groups> 部分重新编码,例如使用 Code(items) = (1,2,3,4), (0,1,2,3);,其中 "items" 是原始记分为 1–4 的题目。
该错误的另一个可能原因是数据集中存在意外取值。例如,如果您声明所有题目都有 2 个类别,flexMIRT™ 期望的是 0 和 1。如果有被试在某题上取值为 2,同样会导致 "Out of Range" 错误。
如何指定缺失数据?
缺失数据的默认值为 -9,可以在 <Groups> 部分通过语句更改为其他任何数值(例如 Missing = 99;)。目前 flexMIRT™ 只能处理数值型的缺失数据,因此句点(.)或空格( )不会被识别为缺失数据,也不能被指定为缺失数据值。
我的数据是为其他程序格式化的,响应之间没有空格。flexMIRT™ 能直接分析这些数据吗?
目前无法指定数据字符串的格式(这会使 flexMIRT™ 无法正确解释响应)。数据文件必须使用空格、制表符或逗号作为变量之间的分隔符,且不能包含变量名表头。
flexMIRT™ 能从其他程序(如 SAS、SPSS、Excel)导入数据吗?
flexMIRT™ 目前不具备导入功能。您需要从原程序将数据导出为适合 flexMIRT™ 的格式。
如何让 flexMIRT™ 仅在响应以列表方式完整存在时才分析数据?
目前 flexMIRT™ 没有指定缺失类型(列表删除、成对删除等)的选项。不过 flexMIRT™ 采用全信息估计,所有可用数据都会纳入似然函数。全信息估计无需此类缺失设定,因为那些设定会减少可用数据点并造成不必要的信息损失。
我有一个超大数据集,包含大量被试、题目和想要估计的因子。flexMIRT™ 能处理的数据集/模型规模有上限吗?
可估计的维度数量、可纳入的题目/被试数量没有实际限制(除非超出您计算机或操作系统的能力)。
功能与技术信息
其他程序为我提供项目特征曲线图和 TIF 曲线。flexMIRT™ 会为我绘图吗?
flexMIRT™ 目前没有集成的绘图功能。不过,绘图所需的全部信息都已在输出中提供,可以轻松转移到具备绘图能力的程序中(如 Excel)。对于单维模型,用户可以在语法的 <Options> 部分加入 flexMIRT™ 3.6 新增的语句 SaveICC = Yes;,构造项目特征曲线/轨迹线图所需的数值将被保存到扩展名为 -icc.txt 的输出文件中。
我们还在支持页面"Plotting Examples"下提供了 R 语法文件,只需极少的用户输入即可导入 flexMIRT™ 参数,并为单维模型绘制基本的轨迹线图。请注意,这些语法文件不提供保修或支持。
可以使用 flexMIRT™ 进行探索性因子分析(EFA)吗?
自 flexMIRT™ 3.0 推出以来,flexMIRT™ 在使用解析旋转进行探索性因子分析方面有着成熟的实践历史。详情请参阅用户手册的"MIRT"和/或"High-Dimensional and Complex Models 的替代估计方法"章节。
我有许多不同的数据集需要分析,想通过命令提示符运行 flexMIRT™,可以吗?
我们已在 flexMIRT™ 用户手册中新增附录(附录 B),介绍如何通过命令行界面运行 flexMIRT™。flexMIRT™ 3.6 还新增了 GUI 功能,支持以点击方式创建和运行批处理文件,同样详见附录 B。
flexMIRT™ 提示我在第 XX 行有错误。有没有办法让 flexMIRT™ 在语法编辑器中显示行号?
新更新的 flexMIRT™ 3.6 GUI 默认显示行号。
在 flexMIRT™ 3.51 中没有行号功能。不过,您可以将代码复制到记事本等文本编辑器中,并在"查看"菜单下开启状态栏,以此找到特定行号,然后按需修改 flexMIRT™ 代码。
flexMIRT™ 在分析中途停止,没有产生任何输出,只报告"Finished in XX ms."。出了什么问题?
根据我们协助用户的经验,最常见的原因是一个或多个题目在指定的响应类别中没有观测值。例如,flexMIRT™ 被告知某题有 4 个类别、应拟合 Graded(4) 模型,但数据中不存在取值为 2 的观测。如果某个类别在数据中从未出现,flexMIRT™ 无法估计这两个类别之间的截距。合并/重新编码数据使观测到的响应取值连续,并指定具有适当类别数的题目模型,是解决该问题的一种方法。
flexMIRT™ 可用内存耗尽也会导致上述现象。常见于使用 EM 算法进行多维模型的校准或计分时,如果积分点未从默认设置(-6 到 6 范围内均匀分布的 49 个点)减少。维度数量线性增加时,积分点数量呈指数增长。对于更高维的模型,如果保持默认值,积分点总数(以及所需内存)可能变得无法承受。控制积分点数量和分布范围的 Quadrature 命令详情,请参阅用户手册的语法(Syntax)章节。
另一种可能的原因是模型不可识别。例如,所有题目都载荷于所有因子的多维模型是不可识别的,无法估计。确保所指定模型在统计上可识别是用户的责任。识别规则超出了软件支持的范围,但我们推荐 Cai(2010)发表于 Psychometrika 的探索性题目因子分析论文,或 Bollen(1989)关于潜变量模型的著作,作为可能的入门材料。
如果您已确认所有题目在所有响应类别中都有观测值、模型可识别,并且尝试过减少积分点数,但问题仍然存在,欢迎联系我们获取进一步帮助。请附上您有效的 flexMIRT™ 许可证代码,通过我们的支持门户发送问题描述、您编写的代码以及数据集(如可能)。我们会尽快回复。
我对多维模型使用极大似然(ML)计分,得到了未定义的值和/或不合理的估计。这是缺陷吗?
我们强烈建议不要对 MIRT 模型使用 ML 计分。尽管已尽力使 ML 计分尽可能稳健,但由于 ML 计分不使用来自总体分布的信息,在对 MIRT 模型的各个维度计分时会忽略关于总体分布的重要统计信息(如因子间相关、均值和方差)。此外,ML 计分可能导致分数信息矩阵非正定,使某些估计的标准误无法定义。
我的模型可以运行但速度极慢。是不是有问题?如何提速?
有些模型非常复杂,需要更长的运行时间。如果您使用多维模型,可以尝试增加 flexMIRT™ 可用的处理器数量(默认为 1),或减少积分点数量——前提是数值积分精度的降低不会实质性损害估计质量和稳定性(默认为 -6 到 6 范围内的 49 个点)。这可分别通过在 flexMIRT™ 语法的 <Options> 部分使用诸如 Processors = 3; 和 Quadrature = 21, 5.0; 之类的语句实现。
如果您运行的是 bifactor 模型,请确保在 <Groups> 部分指定了主维度数量(例如 Primary = 1;),这将允许 flexMIRT™ 采用其降维技术,也应能提高运行速度。
此外,请求计算并打印 M2 拟合优度(GOF)统计量可能增加处理时间,题目数量很大时尤其如此。总体有限信息拟合指数需要计算并求逆非常大的矩阵。例如,100 道题时至少有 100*101/2 = 5,050 个单变量和双变量子表,因此单变量和双变量概率的渐近协方差矩阵为 5,050 x 5,050,包含 5050*5051/2 = 12,753,775 个元素。无论矩阵多大,程序都会尝试计算,但题目数量很大时所需时间将远超其价值。若要及时计算 M2,二分题目的实际上限约为 120 题,多级计分题目约为 50 题。
我在 <Options> 部分指定了 flexMIRT™ 可以使用多个处理器,但估计似乎并没有变快。问题出在哪里?
并行运行(使用多于 1 个处理器)有可能反而更慢,尤其是当问题的复杂度主要由 M 步主导时。Bock-Aitkin EM 算法不容易并行化,因为 E 步和 M 步之间需要大量同步;通常存在一个屏障,处理器必须等待团队所有成员完成后才能进行下一个任务。如果这种开销在比例上大于并行带来的加速,甚至可能使并行化的程序运行更慢。
使用多个处理器获得的加速还取决于问题的规模(被试、题目和维度数量)以及内存消耗量。
我在使用补充 EM(supplemented EM)标准误,但 SEM 循环很快结束而没有收敛?我的题目点估计看起来正常。如何解决?
在语法的 <Options> 部分加入命令 SmartSEM = No;,允许 flexMIRT™ 使用完整的迭代历史,可能带来更好的窗口和收敛的 SEM 算法。如果仍不能解决问题,可在 <Options> 部分将 E 步容差或 M 步容差调整为小于默认值(分别通过 eTol = ; 或 mTol = ;),这也会增大期望 SEM 标准误收敛的窗口范围。但请注意,补充 EM 算法在"smart"窗口内不收敛,往往反映 EM 路径不平滑,提示存在值得探究的模型误差。
我有来自其他程序的项目参数,想用它们在 flexMIRT™ 中给数据计分。如何把现有取值转换为 flexMIRT™ 的 -prm 文件所需的值?
第一步是确定现有项目参数值的度量和参数化方式。在您将构建的 -prm 文件中,flexMIRT™ 默认期望给出逻辑斯蒂度量、斜率/截距(而非斜率/阈值)值。
如果为 3PL 提供猜测参数,-prm 中的值需要是 logit 形式的猜测参数,而非通常的 g 参数。此 PDF 文件提供了 flexMIRT™ 中 3PL(和 GPC)参数化的更多细节。
由于关于 GPC 模型转换的提问较多,此 zip 文件包含了 flexMIRT™ 使用的名目(Nominal)模型详情、一个带标注的 GPC 题目 -prm 文件示例,以及从更常见的 GPC 参数转换为 flexMIRT™ 计分所需 -prm 参数的示例。
如果 flexMIRT™ 只估计截距,那么它报告单维模型时难度/b 参数的标准误从何而来?
b 参数的标准误采用多元 delta 方法获得。具体而言,将 b 视为两个参数(a 和 c)的标量值函数,b(a,c) = –c/a,记 V 为感兴趣的那对 a 和 c 参数对应的协方差矩阵子矩阵:
V =
var(a)
cov(a,c) var(c)
b(a,c) 的雅可比矩阵为 1×2:
J = (db/da db/dc) = (c/a^2 -1/a)
阈值 b 的误差方差的多元 delta 方法近似等于 J V J′。所有矩阵都应在 MLE 处求值。
输出
输出中"Convergence and Numerical Stability"部分的一阶和二阶检验检验的是什么?
一阶检验考察梯度是否已充分消失,使解成为驻点。
二阶检验考察信息矩阵是否正定,这是解成为可能极大值的先决条件。
默认情况下,flexMIRT™ 使用 Bock-Aitkin EM 算法获得边际极大似然估计。对于二阶检验,报告"解是可能极大值"仅意味着程序达到了统计上理想的解。二阶检验结果还可能打印另一种消息:"Solution is not a maximum; caution is advised."。如果收到该消息,所有参数估计都应被视为暂定值,不应用作最终估计,也不应用于后续计分等。
能否将原始名目(nominal)模型参数化保存到 -PRM 文件中?
目前没有将原始参数化值保存到 -PRM 文件的选项,不过它们会在输出中打印。利用保存到 -PRM 文件中的 alpha 和 gamma 值,按照 Thissen、Cai 和 Bock(2010)的公式——特别是式 3.35 和 3.36 所述的 T 矩阵,以及式 3.37–3.41 中的参数转换——用户可以获得原始参数化的估计值。请注意,该章节的式 3.41 存在一处错误,正确的应为:
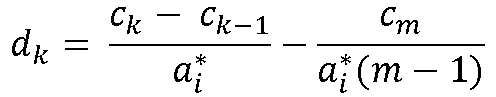
图1:式 3.41 的正确形式
我拟合了多维模型,flexMIRT™ 只打印截距值(c 参数)。我想要阈值(b 值),能让 flexMIRT™ 打印吗?
对于逻辑斯蒂多维模型,阈值参数无法直接推导,且其逻辑和理论基础远为薄弱;因此 flexMIRT™ 不会打印它们。不过,您可以使用以下方法将逻辑斯蒂截距转换为近似的正态度量阈值参数:
首先,将各斜率除以 IRT 标度常数 1.7,使其置于近似正态度量。然后计算重标度后斜率的平方和。将结果加 1.0 并取平方根,即得到转换该题目所有截距所需的常数。
转换截距时,先加上负号,再除以 1.7,使其同样处于正态度量。然后将每个截距除以上面得到的常数。同一题目的所有截距使用同一个常数。但进入下一题时,需要重新计算转换常数。
例如,某题的斜率参数为 a1 = 1.28 和 a2 = 1.67,则转换常数为 sqrt((1.28/1.7)2+(1.67/1.7)2+1) = 1.59。
如果第一个截距值为 5.35,则转换后的阈值参数可先将其置于正态度量(-5.35/1.7 = -3.15),再除以转换常数(-3.15/ 1.59 ≈ -1.98)。
能否从 flexMIRT™ 获得正态度量的参数估计?
如果使用 3PL 模型,在 <Options> 部分加入命令 NormalMetric3PL = Yes;,将在输出中打印正态度量参数,并在请求时打印到 -prm 输出文件中。
如果使用 Graded 模型,没有可用的快捷关键字,但可在 <Constraints> 部分使用 Coeff 关键字,将所需的标度常数(如 1.702)纳入参数估计和报告。Coeff 关键字的使用详情见用户手册的语法(Syntax)章节。注意,-prm 文件将包含通常的逻辑斯蒂度量值,但纳入所请求系数的参数值会输出到调试文件中,可通过在 <Options> 部分设置 SaveDBG = Yes; 请求生成。
使用 Coeff 关键字时,任何指定的先验分布都会施加于纳入所述系数的参数,而非默认估计的参数。例如,如果希望斜率先验分布在逻辑斯蒂度量中的均值为 2.1,则应指定先验语句 Prior, (VarX), slope: normal(1.23, 1.0);,因为 2.1/1.702 = 1.233。
我正在拟合多层模型,并已在 <Options> 部分通过 GOF = Extended; 指定 flexMIRT™ 打印额外的 GOF 指数。即使有该命令,我仍只得到基本指数。为什么?
GOF 命令目前对多层模型无效。多层 IRT 模型的模型拟合检验是一个仍在发展的研究领域。目前只会打印 -2 对数似然、AIC 和 BIC 值。
能否像多层线性回归那样,估计多层 IRT 中各层次解释的方差百分比?
可以对多层 IRT 模型进行方差分解,但目前必须借助输出中的取值手工完成。首先,您必须以允许方差分解的方式设置多层模型。这需要将所有题目斜率约束为在 Between 和 Within 层次间相等。在 Within 层方差固定为 1.0 的识别约束下,Between 层方差可以自由估计。
利用上述模型输出中 Between 和 Within 因子的方差值,可求得归因于 Between 因子的方差为 (VarB/W / (VarB/W + VarW/in))。例如,如果 Within 因子方差被约束为 1.0,估计的 Between 方差为 3.14,则归因于 Between 因子的方差为 3.14 / (3.14 + 1.0) = 0.76,即 76%。
其他
我的问题不在这里。现在该怎么办?
我们随时愿意帮助您解决任何 flexMIRT™ 问题。请附上您有效的 flexMIRT™ 许可证代码、所使用的 flexMIRT™ 版本、您编写的代码以及数据集(如可能),通过我们的支持门户发送问题描述。我们会尽快回复。
在线留言
尊敬的客户朋友,如您有任何意见建议,请通过下表反馈给我们,我们会尽快与您联系。
|

 400-621-1085